
proto3
导航
proto3
参阅 Proto3 语言指南
本指南描述了如何使用协议缓冲区语言来构造你的协议缓冲区数据,包括 .proto 文件的语法和如何从你的 .proto 文件生成数据访问类。它涵盖了协议缓冲区语言的 proto3 版本。
定义消息类型
首先让我们看一个非常简单的例子。假设你想定义一个搜索请求的消息格式,每个搜索请求都有一个查询字符串,你感兴趣的特定结果页面,以及每页的结果数量。这里是你用来定义消息类型的 .proto 文件。
syntax = "proto3";

message SearchRequest {
  string query = 1;
  int32 page_number = 2;
  int32 result_per_page = 3;
}
文件的第一行指定你使用的是
proto3语法:如果你不这样做,协议缓冲区编译器会认为你使用的是proto2。这必须是文件中第一个非空的、非注释的行。SearchRequest消息定义指定了三个字段(名称/值对),每一个字段代表你想在这种类型的消息中包含的数据。每个字段都有一个名称和一个类型。
指定字段类型
在上面的例子中,所有的字段都是 标量类型:两个整数(page_number 和 result_per_page)和一个字符串(query)。然而,你也可以为你的字段指定复合类型,包括枚举和其他消息类型。
分配字段编号
正如你所看到的,消息定义中的每个字段都有一个 唯一的编号。这些数字用于识别你的 消息二进制格式 中的字段,一旦你的消息类型被使用,就不应该改变。范围在 1 到 15 的字段编号需要一个字节来编码,包括字段编号和字段的类型(你可以在 协议缓冲区编码 中找到更多的信息)。16 到 2047 范围内的字段号需要两个字节。所以你应该把字段号 1 到 15 保留给非常频繁出现的消息元素。记住要为将来可能增加的频繁出现的元素留出一些空间。
你可以指定最小的字段号是 \(1\),最大的是 \(2^{29}-1\),即 \(536\,870\,911\)。你也不能使用 19000 到 19999(FieldDescriptor::kFirstReservedNumber 到FieldDescriptor::kLastReservedNumber)这些数字,因为它们是为协议缓冲区实现保留的——如果你在 .proto 中使用这些保留数字之一,协议缓冲区编译器会抱怨。同样地,你也不能使用任何先前 reserved 字段编号。
指定字段规则
你指定消息字段是以下之一:
singular:一个格式良好的消息可以有零或一个这个字段(但不能超过一个)。而这是 proto3 语法的默认字段规则。repeated:这个字段可以在一条格式良好的信息中重复任何次数(包括零)。重复值的顺序将被保留。
在 proto3 中,标量数字类型的重复字段默认使用 packed 编码。
你可以在 协议缓冲区编码 中找到更多关于 packed 编码的信息。
添加更多信息类型
多个消息类型可以在一个 .proto 文件中定义。如果你要定义多个相关的消息,这很有用——因此,例如,如果你想定义与你的 SearchResponse 消息类型相对应的回复消息格式,你可以把它添加到同一个 .proto 中。
message SearchRequest {
  string query = 1;
  int32 page_number = 2;
  int32 result_per_page = 3;
}

message SearchResponse {
 ...
}
组合消息导致臃肿
虽然在一个 .proto 文件中可以定义多种消息类型(如消息、枚举和服务),但如果在一个文件中定义大量具有不同依赖性的消息,也会导致依赖性臃肿。建议在每个 .proto 文件中包含尽可能少的消息类型。
添加注释
要给你的 .proto 文件添加注释,请使用 C/C++ 风格的 // 和 /* ... */ 语法。
/* SearchRequest represents a search query, with pagination options to
 * indicate which results to include in the response. */

message SearchRequest {
  string query = 1;
  int32 page_number = 2;  // Which page number do we want?
  int32 result_per_page = 3;  // Number of results to return per page.
}
保留字段
如果你通过完全删除一个字段来更新一个消息类型,或者把它注释掉,那么未来的用户在对该类型进行自己的更新时可以重复使用这个字段的编号。如果他们后来加载同一 .proto 的旧版本,这可能会导致严重的问题,包括数据损坏、隐私错误等等。确保这种情况不会发生的一个方法是指定你删除的字段的字段号(和/或名称,这也会给 JSON 序列化带来问题)被保留。如果将来有任何用户试图使用这些字段标识符,协议缓冲区编译器会抱怨。
message Foo {
  reserved 2, 15, 9 to 11;
  reserved "foo", "bar";
}
注意,你不能在同一 reserved 语句中混合使用字段名和字段号。
从你的 .proto 中生成了什么?
当你在 .proto 上运行协议缓冲区编译器时,编译器会用你选择的语言生成你需要的代码,以处理你在文件中描述的消息类型,包括获取和设置字段值,将你的消息序列化到输出流中,并从输入流中解析你的消息。
对于 C++,编译器从每个
.proto中生成一个.h和.cc文件,为文件中描述的每个消息类型生成一个类。对于 Java,编译器为每个消息类型生成一个
.java文件,以及用于创建消息类实例的特殊 Builder 类。Python 有点不同-——Python 编译器在你的
.proto中生成一个带有每个消息类型的静态描述符的模块,然后与元类一起使用,在运行时创建必要的 Python 数据访问类。对于 Go 来说,编译器会生成一个
.pb.go文件,为你文件中的每个消息类型提供一个类型。
你可以按照你所选择的语言的教程来了解更多关于使用每种语言的 API 的信息。关于更多的 API 细节,请看相关的 API 参考资料。
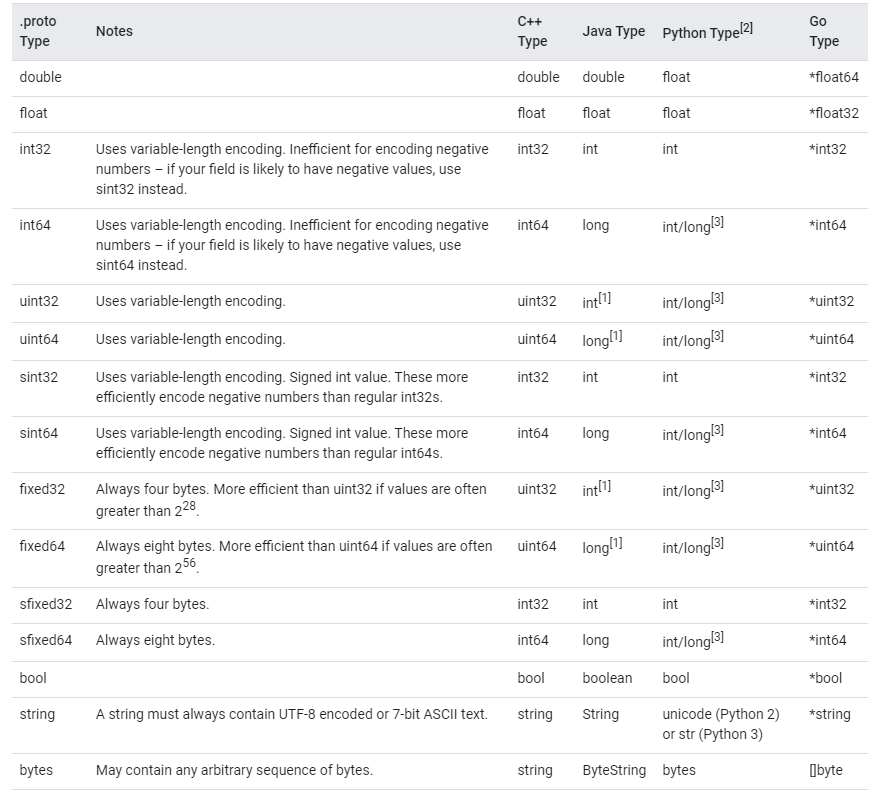
默认值
当消息被解析时,如果编码后的消息不包含一个特定的 singular 元素,解析后的对象中的相应字段就会被设置为该字段的默认值。这些默认值是特定类型的:
对于字符串,默认值是空字符串。
对于字节,默认值是空的字节字符串。
对于 Bools,默认值是
false。对于数字类型,默认值是
0。对于枚举,默认值是枚举的类型定义中列出的第一个值。
对于消息字段,该字段不被设置。它的确切值是取决于语言的。详见 代码生成指南。
repeated 字段的默认值是空的(一般是相应语言中的空列表)。
提示
请注意,对于标量消息字段,一旦消息被解析,就没有办法知道一个字段是否被明确地设置为默认值(例如,一个布尔值是否被设置为 false)或者根本就没有被设置:在定义你的消息类型时,你应该记住这一点。例如,如果你不希望某些行为在默认情况下发生,那么就不要设置一个布尔值,当它被设置为 false 时,就会开启某些行为。还要注意的是,如果一个标量消息字段被设置为默认值,那么该值将不会在 wire 上被序列化。
枚举
当你定义一个消息类型时,你可能希望它的一个字段只具有预定义的值列表中的一个。例如,假设你想为每个 SearchRequest 添加一个 corpus 字段,corpus 可以是 UNIVERSAL、WEB、IMAGES、LOCAL、NEWS、PRODUCTS 或 VIDEO。你可以通过在你的消息定义中添加一个 enum 来实现这个目的:一个具有 enum 类型的字段只能有一组指定的常数作为它的值(如果你试图提供一个不同的值,解析器会把它当作一个未知的字段)。
在下面的例子中,我们添加了一个名为 Corpus 的 enum,其中包含所有可能的值,还有一个 Corpus 类型的字段。
message SearchRequest {
  string query = 1;
  int32 page_number = 2;
  int32 result_per_page = 3;
  enum Corpus {
    UNIVERSAL = 0;
    WEB = 1;
    IMAGES = 2;
    LOCAL = 3;
    NEWS = 4;
    PRODUCTS = 5;
    VIDEO = 6;
  }
  Corpus corpus = 4;
}
正如你所看到的,Corpus 枚举的第一个常量映射为零:每个枚举定义必须包含一个映射为零的常量作为其第一个元素。这是因为:
必须有一个零值,这样我们就可以用 0 作为数字的默认值。
零值需要是第一个元素,以便与 proto2 语义兼容,在 proto2 中第一个枚举值总是默认值。
你可以通过给不同的枚举常量分配相同的值来定义别名。要做到这一点,你需要将 allow_alias 选项设置为 true,否则当发现别名时,协议编译器会产生错误信息。
message MyMessage1 {
  enum EnumAllowingAlias {
    option allow_alias = true;
    UNKNOWN = 0;
    STARTED = 1;
    RUNNING = 1;
  }
}
message MyMessage2 {
  enum EnumNotAllowingAlias {
    UNKNOWN = 0;
    STARTED = 1;
    // RUNNING = 1;  // Uncommenting this line will cause a compile error inside Google and a warning message outside.
  }
}
枚举器常量必须在 32 位整数的范围内。由于枚举值在 wire 上使用 varint 编码,负值的效率很低,因此不推荐使用。你可以在一个消息定义中定义枚举,就像上面的例子一样,也可以在外面定义——这些枚举可以在你的 .proto 文件中的任何消息定义中重复使用。你也可以使用语法 _MessageType_._EnumType_,将一条消息中声明的枚举类型作为另一条消息中的字段类型。
当你在一个使用枚举的 .proto 上运行协议缓冲区编译器时,生成的代码对于 Java 或 C++ 将有一个相应的枚举,或者对于 Python 有一个特殊的 EnumDescriptor 类,用来在运行时生成的类中创建一组具有整数值的符号常量。
小心
生成的代码可能会受到特定语言对枚举器数量的限制(一种语言低至数千)。请查看你计划使用的语言的限制。
在反序列化过程中,未被识别的枚举值将被保留在消息中,尽管当消息被反序列化时如何表示是取决于语言的。在支持开放枚举类型的语言中,其值超出了指定的符号范围,如 C++ 和 Go,未知的枚举值被简单地存储为其基础的整数表示。在具有封闭枚举类型的语言中,如 Java,枚举中的一个案例被用来表示一个未被识别的值,而底层的整数可以用特殊的访问器来访问。在这两种情况下,如果消息被序列化,未被识别的值仍将与消息一起被序列化。
关于如何在你的应用程序中使用消息枚举的更多信息,请参阅你 所选语言的生成代码 指南。
使用其他消息类型
你可以使用其他消息类型作为字段类型。例如,假设你想在每个 SearchResponse 消息中包含结果消息——要做到这一点,你可以在同一个 .proto 中定义一个结果消息类型,然后在 SearchResponse 中指定一个结果类型的字段。
message SearchResponse {
  repeated Result results = 1;
}

message Result {
  string url = 1;
  string title = 2;
  repeated string snippets = 3;
}
导入定义
在上面的例子中,Result 消息类型与 SearchResponse 定义在同一个文件中——如果你想用作字段类型的消息类型已经在另一个 .proto 文件中定义了呢?
你可以通过导入来使用其他 .proto 文件的定义。要导入另一个 .proto 的定义,你要在文件的顶部添加一个导入语句。
import "myproject/other_protos.proto";
默认情况下,你只能使用直接导入的 .proto 文件的定义。然而,有时你可能需要将一个 .proto 文件移动到一个新的位置。与其直接移动 .proto 文件并在一次更改中更新所有的调用站点,你可以在旧的位置放一个占位符 .proto 文件,使用 import public 概念将所有的导入转到新的位置。
提示
请注意,公共导入功能在 Java 中是不可用的。
import public 依赖关系可以被任何导入包含 import public 语句的 proto 的代码所过渡依赖。比如说:
// new.proto
// All definitions are moved here
// old.proto
// This is the proto that all clients are importing.
import public "new.proto";
import "other.proto";
// client.proto
import "old.proto";
// You use definitions from old.proto and new.proto, but not other.proto
协议编译器在协议编译器命令行上使用 -I/--proto_path 标志指定的一组目录中搜索导入的文件。如果没有给出标志,它就在编译器被调用的目录中寻找。一般来说,你应该将 --proto_path 标志设置为项目的根目录,并对所有导入文件使用完全合格的名称。
使用 proto2 消息类型
可以导入 proto2 消息类型并在你的 proto3 消息中使用它们,反之亦然。然而,proto2 的枚举不能用于 proto3 的语法。
嵌套类型
你可以在其他消息类型中定义和使用消息类型,就像下面的例子一样:这里,Result 消息被定义在 SearchResponse 消息中。
message SearchResponse {
  message Result {
    string url = 1;
    string title = 2;
    repeated string snippets = 3;
  }
  repeated Result results = 1;
}
如果你想在其父级消息类型之外重复使用这个消息类型,你就把它称为 _Parent_._Type_:
message SomeOtherMessage {
  SearchResponse.Result result = 1;
}
你可以根据自己的意愿对信息进行深度嵌套:
message Outer {                  // Level 0
  message MiddleAA {  // Level 1
    message Inner {   // Level 2
      int64 ival = 1;
      bool  booly = 2;
    }
  }
  message MiddleBB {  // Level 1
    message Inner {   // Level 2
      int32 ival = 1;
      bool  booly = 2;
    }
  }
}
更新消息类型
如果一个现有的消息类型不再满足你的所有需求——例如,你希望消息格式有一个额外的字段——但你仍然想使用用旧格式创建的代码,不要担心!更新消息类型非常简单,不会破坏你现有的任何代码。只要记住以下规则:
不要改变任何现有字段的字段编号。
如果你添加了新的字段,任何由使用你的 “旧” 消息格式的代码序列化的消息仍然可以被你新生成的代码解析。你应该记住这些元素的 默认值,以便新的代码可以正确地与旧代码生成的消息互动。同样,由你的新代码创建的消息可以被你的旧代码解析:旧的二进制文件在解析时只需忽略新字段。详见 未知字段 部分。
字段可以被删除,只要字段号不在你更新的消息类型中再次使用。你可能想重命名这个字段,也许加上前缀 “OBSOLETE_”,或者把字段号保留下来,这样你的
.proto的未来用户就不会意外地重复使用这个号码。int32、uint32、int64、uint64和bool都是兼容的——这意味着你可以将一个字段从这些类型中的一个改为另一个,而不会破坏向前或向后的兼容。如果从 wire 上解析出的数字不符合相应的类型,你会得到与你在 C++ 中把数字投到该类型的相同效果(例如,如果一个 64 位的数字被读成int32,它将被截断为 32 位)。sint32和sint64是相互兼容的,但与其他整数类型不兼容。只要字节是有效的UTF-8,
bytes和string是兼容的。如果
bytes包含信息的编码版本,则嵌入式信息与字节兼容。fixed32与sfixed32兼容,而fixed64与sfixed64兼容。对于
string、bytes和消息字段,optional与repeated兼容。给出重复字段的序列化数据作为输入,如果是原始类型的字段,期望这个字段是optional客户端将采取最后的输入值,如果是消息类型的字段,将合并所有输入元素。请注意,这对于数字类型,包括 bool 和enum,通常是不安全的。数字类型的重复字段可以用packed的格式进行序列化,当期望有一个optional字段时,这将不能被正确解析。改变默认值一般是可以的,只要你记住默认值是不会在 wire 发送的。因此,如果一个程序收到一个没有设置特定字段的消息,该程序将看到默认值,因为它是在该程序的协议版本中定义的。它不会看到发件人代码中定义的默认值。
enum与int32、uint32、int64和uint64在 wire 格式上是兼容的(注意,如果数值不合适,会被截断),但是要注意,当消息被反序列化时,客户端代码可能会对它们进行不同的处理。值得注意的是,当消息被反序列化时,未被识别的enum值会被丢弃,这使得字段的has..访问器返回false,其getter返回enum定义中列出的第一个值,或者默认值(如果指定了一个)。在重复enum字段的情况下,任何未被识别的值都会从列表中剥离出来。然而,一个整数字段将始终保留其值。正因为如此,当把一个整数升级为enum时,你需要非常小心,以免在电线上收到超界的enum值。将一个单一的可选值改成一个 new
oneof的成员是安全的,而且二进制兼容。将多个可选字段移入一个新的oneof中可能是安全的,如果你确信没有代码同时设置多个字段的话。将任何字段移入一个现有的oneof中是不安全的。
未知字段
未知(Unknown)字段是格式良好的协议缓冲区序列化数据,代表解析器不认识的字段。例如,当一个旧的二进制文件解析一个新的二进制文件发送的带有新字段的数据时,这些新字段就成为旧二进制文件中的未知字段。
最初,proto3 消息在解析过程中总是丢弃未知字段,但在 3.5 版本中,我们重新引入了对未知字段的保留,以匹配 proto2 行为。在 3.5 及以后的版本中,未知字段在解析过程中被保留,并包含在序列化的输出中。
Any
Any 消息类型让你把消息作为嵌入式类型使用,而不需要他们的 .proto 定义。一个 Any 包含一个任意的序列化消息的字节,以及一个作为全局唯一标识符的 URL,并解析为该消息的类型。要使用 Any 类型,你需要导入 google/protobuf/any.proto。
import "google/protobuf/any.proto";

message ErrorStatus {
  string message = 1;
  repeated google.protobuf.Any details = 2;
}
给定消息类型的默认类型 URL 是 type.googleapis.com/_packagename_._messagename_。
不同的语言实现将支持运行时库帮助器,以类型安全的方式打包和解压 Any 值——例如,在 Java 中,Any 类型将有特殊的 pack() 和 unpack() 访问器,而在 C++ 中有 PackFrom() 和 UnpackTo() 方法。
// Storing an arbitrary message type in Any.
NetworkErrorDetails details = ...;
ErrorStatus status;
status.add_details()->PackFrom(details);

// Reading an arbitrary message from Any.
ErrorStatus status = ...;
for (const Any& detail : status.details()) {
  if (detail.Is<NetworkErrorDetails>()) {
    NetworkErrorDetails network_error;
    detail.UnpackTo(&network_error);
    ... processing network_error ...
  }
}
目前,用于处理 Any 类型的运行时库正在开发中。
如果你已经熟悉了 proto2 的语法,Any 可以容纳任意的 proto3 消息,类似于 proto2 消息,可以允许 扩展。
Oneof
如果你有一条有许多可选字段的消息,并且最多只有一个字段会同时被设置,你可以通过使用 oneof 功能来强制执行这一行为并节省内存。
oneof 字段和可选字段一样,只是 oneof 中的所有字段都共享内存,而且最多只能同时设置一个字段。设置 oneof 中的任何成员都会自动清除所有其他成员。你可以使用一个特殊的 case() 或 WhichOneof() 方法来检查 oneof 中的哪个值被设置了(如果有的话),这取决于你选择的语言。
使用 Oneof
要在你的 .proto 中定义一个 oneof,你要使用 oneof 关键字,后面跟着你的 oneof 名称,在这里是 test_oneof:
message SampleMessage {
  oneof test_oneof {
    string name = 4;
    SubMessage sub_message = 9;
  }
}
然后你将你的 oneof 字段添加到 oneof 定义中。你可以添加任何类型的字段,除了 map 字段和 repeated 字段。
在你生成的代码中,oneof 字段与普通的可选方法有相同的 getters 和 setters。你还会得到一个特殊的方法来检查 oneof 中的哪个值(如果有的话)被设置。你可以在相关的 API 参考资料中找到更多关于你所选语言的 oneof API 的信息。
Oneof 特征
设置一个 oneof 字段将自动清除 oneof 中的所有其他成员。因此,如果你设置了几个 oneof 字段,只有你设置的最后一个字段仍然有一个值。
SampleMessage message;
message.set_name("name");
CHECK(message.has_name());
message.mutable_sub_message();   // Will clear name field.
CHECK(!message.has_name());
如果解析器在 wire 上遇到多个相同的
oneof成员,那么在解析的消息中只使用最后看到的成员。oneof不支持扩展。一个
oneof不能被重复。反射 API 对
oneof字段有效。如果你将一个
oneof字段设置为默认值(例如将一个int32的oneof字段设置为0),该oneof字段的 “case” 将被设置,并且该值将在 wire 上被序列化。如果你使用 C++,确保你的代码不会导致内存崩溃。下面的示例代码会崩溃,因为
sub_message已经通过调用set_name()方法被删除了。
SampleMessage message;
SubMessage* sub_message = message.mutable_sub_message();
message.set_name("name");      // Will delete sub_message
sub_message->set_...            // Crashes here
同样在 C++ 中,如果你用 oneofs Swap() 两个消息,每个消息最后都会有对方的 oneof 情况:在下面的例子中,msg1 会有一个 sub_message,msg2 会有一个名字。
SampleMessage msg1;
msg1.set_name("name");
SampleMessage msg2;
msg2.mutable_sub_message();
msg1.swap(&msg2);
CHECK(msg1.has_sub_message());
CHECK(msg2.has_name());
向后兼容的问题
在添加或删除 oneof 字段时要小心。如果检查 oneof 的值返回 None/NOT_SET,这可能意味着 oneof 没有被设置,或者它被设置为不同版本的 oneof 中的一个字段。没有办法区分,因为没有办法知道线上的未知字段是否是 oneof 的成员。
标签重复使用问题
将可选字段移入或移出一个 oneof:在消息被序列化和解析后,你可能会失去一些信息(一些字段会被清除)。然而,你可以安全地将一个字段移入一个新的 oneof 中,如果知道只有一个字段被设置的话,你也许可以移动多个字段。
删除一个 oneof 字段,然后把它加回来:这可能会在消息被序列化和解析后清除你当前设置的 oneof 字段。
拆分或合并 oneof:这与移动普通的可选字段有类似的问题。
Maps
如果你想创建一个关联映射作为数据定义的一部分,协议缓冲区提供了一个方便的快捷语法。
map<key_type, value_type> map_field = N;
…其中 key_type 可以是任何积分或字符串类型(所以,除了浮点类型和字节之外的任何标量类型)。请注意,enum 不是有效的 key_type。value_type 可以是任何类型,除了另一个 map。
因此,例如,如果你想创建一个项目 map,其中每个 Project 信息与一个字符串键相关联,你可以这样定义它。
map<string, Project> projects = 3;
map字段不能是repeated。map值的 wire 格式排序和map迭代排序是未定义的,所以你不能依赖你的map项目在一个特定的顺序。在为
.proto生成文本格式时,map是按键排序的。数值键是按数字排序的。当从 wire 上解析或合并时,如果有重复的
map键,则使用最后看到的键。当从文本格式解析一个map时,如果有重复的键,解析可能会失败。如果你为一个
map字段提供了一个键,但没有提供值,当字段被序列化时,其行为是与语言有关的。在 C++、Java、Kotlin 和 Python 中,该类型的默认值会被序列化,而在其他语言中,什么都不会被序列化。
生成的 map API 目前可用于所有 proto3 支持的语言。你可以在相关的 API 参考中找到更多关于你所选语言的 map API。
向后兼容
map 语法等同于 wire 上的以下内容,所以不支持 map 的协议缓冲区实现仍然可以处理你的数据。
message MapFieldEntry {
  key_type key = 1;
  value_type value = 2;
}

repeated MapFieldEntry map_field = N;
任何支持 map 的协议缓冲区实现都必须同时产生和接受可以被上述定义接受的数据。
包
你可以在 .proto 文件中添加一个可选的包指定器,以防止协议消息类型之间的名称冲突。
package foo.bar;
message Open { ... }
然后你可以在定义你的消息类型的字段时使用包指定器:
message Foo {
  ...
  foo.bar.Open open = 1;
  ...
}
包指定符影响生成代码的方式取决于你选择的语言。
在 C++ 中,生成的类被包裹在一个 C++ 命名空间中。例如,
Open将被放在命名空间foo::bar中。在 Java 中,除非你在你的
.proto文件中明确地提供一个选项java_package,否则包将作为 Java 包使用。在 Python 中,包指令被忽略,因为 Python 模块是根据它们在文件系统中的位置来组织的。
在 Go 中,包指令被忽略,生成的
.pb.go文件在以相应的go_proto_library规则命名的包中。
即使包指令不直接影响生成的代码,例如在 Python 中,仍然强烈建议为 .proto 文件指定包,否则可能导致描述符中的命名冲突,并使 proto 在其他语言中无法移植。
包和名称解析
在协议缓冲区语言中,类型名称解析的工作方式与 C++ 类似:首先搜索最内层的范围,然后是下一个最内层的范围,以此类推,每个包都被认为是其父包的 “内部”。前面的’.’(例如,.foo.bar.Baz)意味着要从最外层的范围开始。
协议缓冲区编译器通过解析导入的 .proto 文件来解决所有的类型名称。每种语言的代码生成器知道如何引用该语言中的每个类型,即使它有不同的范围规则。
定义服务
如果你想在 RPC(远程过程调用)系统中使用你的消息类型,你可以在 .proto 文件中定义一个 RPC 服务接口,协议缓冲区编译器将用你选择的语言生成服务接口代码和存根。因此,举例来说,如果你想定义一个 RPC 服务的方法,该方法接收你的 SearchRequest 并返回 SearchResponse,你可以在你的 .proto 文件中定义它,如下:
service SearchService {
  rpc Search(SearchRequest) returns (SearchResponse);
}
默认情况下,协议编译器将生成一个名为 SearchService 的抽象接口和一个相应的 “stub” 实现。存根将所有调用转发到 RpcChannel,而 RpcChannel 又是一个抽象接口,你必须根据自己的 RPC 系统来定义。例如,你可以实现一个 RpcChannel,它将消息序列化并通过 HTTP 将其发送到服务器。换句话说,生成的存根为进行基于协议缓冲区的 RPC 调用提供了一个类型安全的接口,而不会将你锁定在任何特定的 RPC 实现中。因此,在 C++ 中,你可能最终会得到这样的代码:
using google::protobuf;

protobuf::RpcChannel* channel;
protobuf::RpcController* controller;
SearchService* service;
SearchRequest request;
SearchResponse response;

void DoSearch() {
  // You provide classes MyRpcChannel and MyRpcController, which implement
  // the abstract interfaces protobuf::RpcChannel and protobuf::RpcController.
  channel = new MyRpcChannel("somehost.example.com:1234");
  controller = new MyRpcController;

  // The protocol compiler generates the SearchService class based on the
  // definition given above.
  service = new SearchService::Stub(channel);

  // Set up the request.
  request.set_query("protocol buffers");

  // Execute the RPC.
  service->Search(controller, request, response, protobuf::NewCallback(&Done));
}

void Done() {
  delete service;
  delete channel;
  delete controller;
}
所有的服务类也都实现了服务接口,它提供了一种调用特定方法的方法,而不需要在编译时知道方法的名称或其输入和输出类型。在服务器端,这可以用来实现一个 RPC 服务器,你可以用它来注册服务。
using google::protobuf;

class ExampleSearchService : public SearchService {
 public:
  void Search(protobuf::RpcController* controller,
              const SearchRequest* request,
              SearchResponse* response,
              protobuf::Closure* done) {
    if (request->query() == "google") {
      response->add_result()->set_url("http://www.google.com");
    } else if (request->query() == "protocol buffers") {
      response->add_result()->set_url("http://protobuf.googlecode.com");
    }
    done->Run();
  }
};

int main() {
  // You provide class MyRpcServer.  It does not have to implement any
  // particular interface; this is just an example.
  MyRpcServer server;

  protobuf::Service* service = new ExampleSearchService;
  server.ExportOnPort(1234, service);
  server.Run();

  delete service;
  return 0;
}
如果你不想插入你自己现有的 RPC 系统,你现在可以使用 gRPC:一个在 Google 开发的语言和平台中立的开源 RPC 系统。gRPC 在协议缓冲区方面工作得特别好,让你使用一个特殊的协议缓冲区编译器插件直接从你的 .proto 文件生成相关的 RPC 代码。然而,由于用 proto2 和 proto3 生成的客户端和服务器之间存在潜在的兼容性问题,我们建议你使用 proto3 来定义 gRPC 服务。
除了 gRPC 之外,还有一些正在进行的第三方项目,为协议缓冲区开发 RPC 实现。关于我们所知道的项目的链接列表,请参见第三方附加组件 wiki 页面。
选项
.proto 文件中的单个声明可以用一些选项进行注释。选项并不改变声明的整体含义,但可能会影响它在特定情况下的处理方式。可用选项的完整列表在 google/protobuf/descriptor.proto 中定义。
有些选项是文件级的选项,意味着它们应该写在顶层范围内,而不是在任何消息、枚举或服务定义内。有些选项是消息级的,意味着它们应该写在消息定义中。有些选项是字段级的,意思是它们应该写在字段定义里面。选项也可以写在枚举类型、枚举值、oneof 字段、服务类型和服务方法上;然而,目前没有任何有用的选项存在于这些方面。
下面是几个最常用的选项:
生成你的类
为了生成你需要的 Java、Python 或 C++ 代码来处理 .proto 文件中定义的消息类型,你需要在 .proto 上运行协议缓冲区编译器 protoc。
协议编译器的调用方法如下:
protoc --proto_path=IMPORT_PATH --cpp_out=DST_DIR --java_out=DST_DIR --python_out=DST_DIR --go_out=DST_DIR --ruby_out=DST_DIR --objc_out=DST_DIR --csharp_out=DST_DIR path/to/file.proto
IMPORT_PATH指定了一个在解析导入指令时寻找.proto文件的目录。如果省略,将使用当前目录。可以通过多次传递--proto_path选项来指定多个导入目录;它们将被按顺序搜索。-IIMPORT_PATH可以作为--proto_path的缩写形式。你可以提供一个或多个输出指令:
--cpp_out在DST_DIR中生成C++代码。更多内容请参见 C++ 生成的代码参考。--java_out在DST_DIR中生成Java代码。更多内容请参见 Java 生成的代码参考。--python_out在DST_DIR中生成Python代码。更多内容请参见 Python 生成的代码参考。
作为一种额外的便利,如果
DST_DIR以.zip或.jar结尾,编译器将把输出写入一个给定名称的ZIP格式的归档文件。如果输出档案已经存在,它将被覆盖。编译器不够聪明,无法将文件添加到现有的存档中。你必须提供一个或多个
.proto文件作为输入。可以同时指定多个.proto文件。尽管这些文件是相对于当前目录命名的,但每个文件都必须位于IMPORT_PATH之中,以便编译器能够确定其标准名称。